
 Garanzia di Download Sicuro, zero malware


Se cerchi una soluzione ai sottotitoli con caratteri strani e accenti sbagliati, parti dal file originale. Una è diventata una sequenza come è? Oppure compare un quadratino al posto della lettera? Sono sintomi diversi: il primo suggerisce un problema di interpretazione dei byte, il secondo può dipendere dal font o da un carattere non disponibile.
Rinominare il file o cambiare la lingua del video non risolve questi problemi. Bisogna distinguere testo salvato male, decodifica errata e limite di visualizzazione, prima di introdurre modifiche che potrebbero rendere il recupero più difficile.
Risposta rapida: conserva l'originale e prova UTF-8
Apri una copia dell'SRT in un editor che permetta di scegliere la codifica in lettura. Se trovi una codifica che mostra correttamente parole come perché, città e più, salva una nuova copia UTF-8. Se il testo è già corretto nell'editor ma sbagliato nel lettore, controlla invece la codifica impostata dal lettore e il font utilizzato.
Non convertire alla cieca un file che mostra già simboli di sostituzione. Salvare quel testo in UTF-8 può rendere stabile l'errore anziché recuperare l'accento originale. Quando i caratteri sono stati persi durante un salvataggio precedente, potrebbe servire una copia precedente o una correzione manuale basata sull'audio.
| Sintomo | Possibile origine | Prima verifica |
|---|---|---|
| è al posto di è | UTF-8 interpretato come altra codifica | Riaprire i byte originali |
| � al posto delle lettere | Decodifica fallita o perdita già salvata | Confrontare una copia originale |
| Rettangoli vuoti | Glifi assenti nel font | Provare un font adeguato |
| Testo corretto, tempi assenti | Struttura SRT alterata | Controllare timecode e separatori |
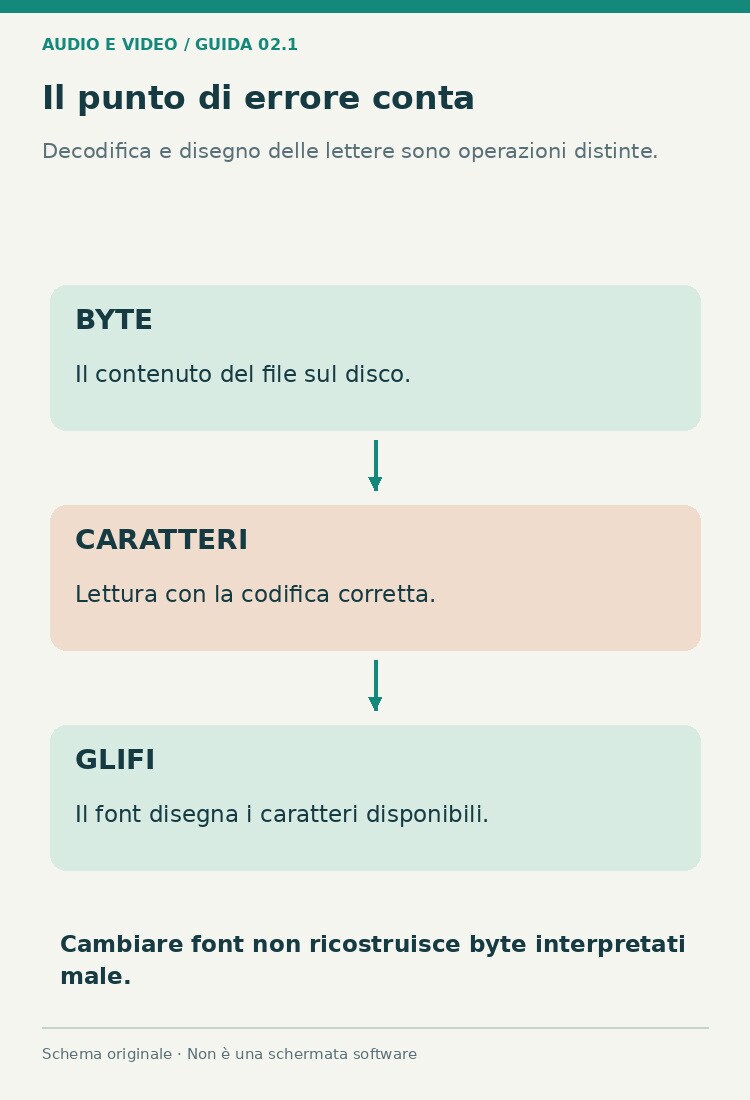
Codifica, font e formato non sono la stessa cosa
La codifica stabilisce come i byte diventano caratteri. Il font disegna quei caratteri. Il formato SRT organizza numeri dei cue, intervalli temporali e testo. Puoi avere un file UTF-8 perfetto con un font inadatto, oppure un font completo che mostra fedelmente lettere già corrotte.
Un caso frequente nasce quando i byte UTF-8 di una lettera accentata vengono letti come Windows-1252. Il risultato può sembrare una coppia di simboli. Un altro caso riguarda un file legacy Windows-1252 letto come UTF-8: alcuni byte non costituiscono sequenze valide e possono diventare simboli di sostituzione.
Queste osservazioni sono indizi, non un rilevatore universale. I file contenenti soltanto caratteri ASCII non distinguono facilmente fra varie codifiche compatibili. Usa parole con accenti, apostrofi tipografici e nomi propri per verificare la scelta; controlla anche eventuali righe in altre lingue.
Aprire correttamente prima di convertire
In Subtitle Edit carica il file originale e controlla il campo della codifica disponibile nella tua versione. Se il testo appare sbagliato, cambia l'interpretazione del file prima del salvataggio. Non applicare contemporaneamente traduzione, sostituzione dei caratteri e correzione dei tempi: altrimenti non saprai quale operazione ha introdotto un errore.
- Duplica il file e conserva una copia non modificata.
- Individua almeno cinque parole con accenti distribuite nel testo.
- Prova la lettura UTF-8 e, per un vecchio file occidentale, verifica eventualmente Windows-1252.
- Quando il testo è corretto, salva una copia UTF-8 con nome nuovo.
- Riapri la copia salvata e controlla le stesse parole.
- Caricala nel lettore di destinazione senza riutilizzare una versione memorizzata in precedenza.
Il passaggio decisivo è il terzo: interpretare correttamente il contenuto esistente. La conversione successiva deve partire dal testo corretto. Un comando chiamato Converti in UTF-8 può fare qualcosa di diverso da Riapri con codifica UTF-8; controlla la documentazione dell'editor invece di basarti solo sulla parola UTF-8.
Modulo risorsa 1 — Struttura e codifica: il riferimento SubRip di Subtitle Edit documenta il formato e raccomanda UTF-8. È un riferimento utile anche per separatori fra blocchi e compatibilità del testo formattato.
UTF-8 con BOM o senza BOM?
Il BOM UTF-8 è una sequenza iniziale che alcuni software usano come indicazione della codifica. Non è un accento e non dovrebbe apparire come parte del primo sottotitolo. Il supporto varia: per una consegna nuova puoi partire da UTF-8 senza BOM, poi verificare i requisiti specifici del dispositivo o della piattaforma.
Non trasformare questa preferenza in una regola assoluta per ogni televisore o software. Se una piattaforma richiede esplicitamente un'impostazione, seguila. Crea due piccoli file di prova identici nel contenuto, uno con BOM e uno senza, invece di riconvertire più volte l'intero archivio senza sapere quale differenza stai testando.
Se il primo cue non viene riconosciuto, considera anche righe vuote iniziali, numerazione e timecode. Il BOM è una possibile causa di incompatibilità, non una spiegazione automatica per ogni SRT che non viene caricato.
Quando il problema è il font
Apri la stessa riga in un editor di testo e nel lettore. Se l'editor mostra correttamente il carattere ma il lettore visualizza un rettangolo, prova un font con il repertorio necessario. Per un'intervista con nomi stranieri non basta controllare soltanto le vocali italiane: possono esserci segni o alfabeti aggiuntivi.
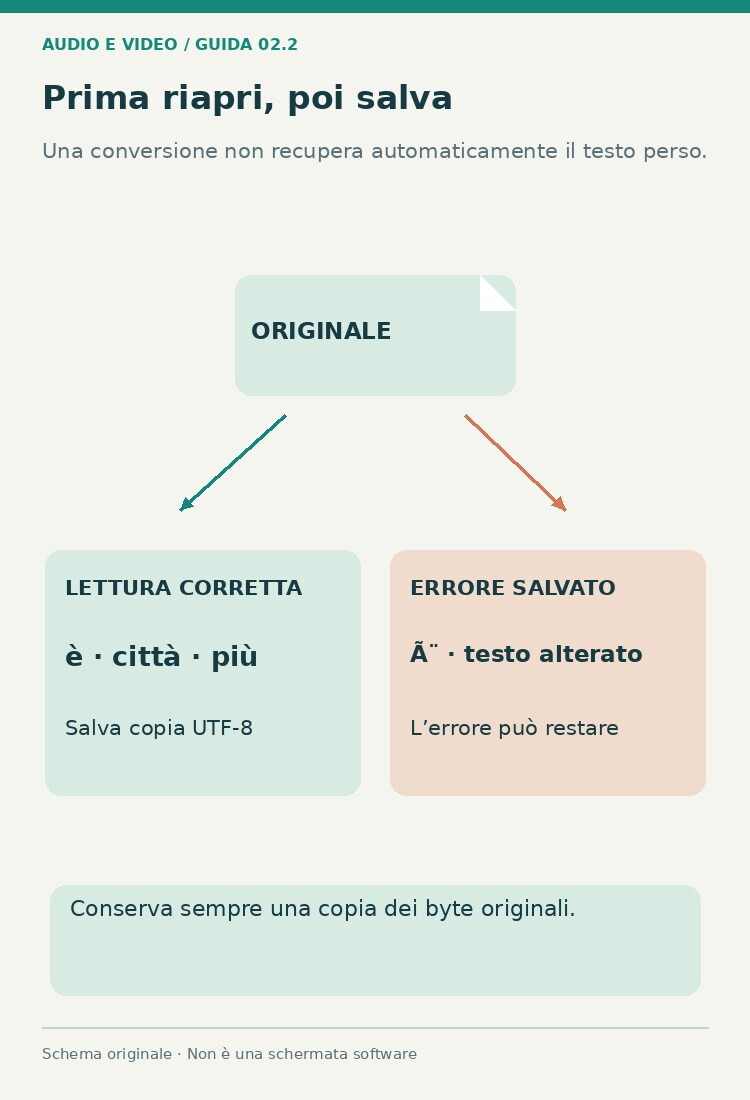
Cambiare font non ripara una sequenza già diventata è. Il font può disegnare meglio quei due caratteri, ma non sapere che avrebbero dovuto essere una sola lettera. Allo stesso modo, togliere tutti gli accenti per far sparire il problema impoverisce il testo e altera parole come è e e.
Controlla peso, corsivo e file del font effettivamente disponibili. Se il progetto passa a un altro computer, il programma potrebbe sostituire il carattere tipografico. Quando distribuisci un font insieme a un progetto, verifica che la sua licenza consenta la condivisione prevista; non allegarlo automaticamente solo perché è installato sul tuo PC.
Riparare un file già salvato male
Se disponi ancora dei byte originali, la riapertura con codifica corretta è la strada preferibile. Se invece il file è stato salvato dopo una decodifica sbagliata, devi capire se l'errore è reversibile. Una sequenza coerente di mojibake può essere recuperabile, mentre un simbolo di sostituzione spesso indica informazione non più presente in quella copia.
Evita sostituzioni globali senza controllo. Una coppia di simboli che rappresenta è in una riga potrebbe far parte di un nome proprio in un'altra. Prepara una tabella di pochi casi ricorrenti, applica le correzioni a una copia e rileggi le occorrenze modificate, prestando attenzione a maiuscole e apostrofi.
Per un numero limitato di errori, riascolta il parlato e riscrivi le parole corrette. Se il file contiene più lingue, coinvolgi chi le conosce: ripristinare un accento non è sempre una sostituzione tecnica univoca. Conserva una nota delle modifiche manuali per il controllo editoriale finale.
Esempio di verifica senza trasformazioni distruttive
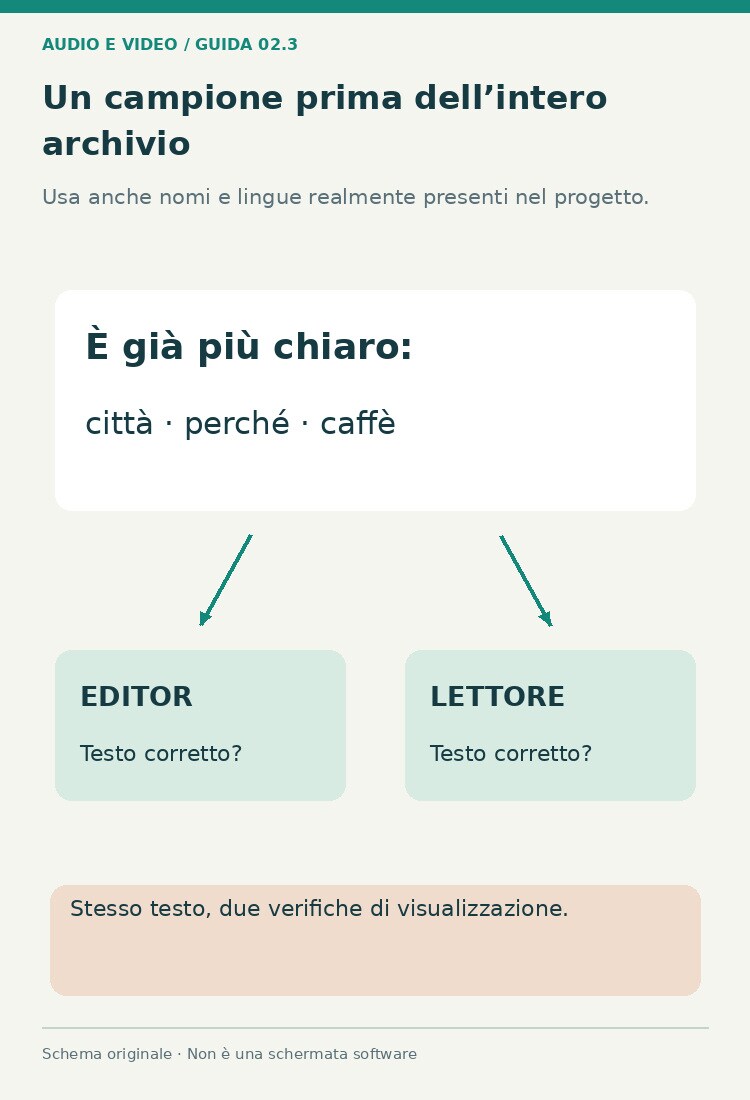
Crea un breve SRT di prova con la frase È già più chiaro: città, perché, caffè. Salvalo separatamente e controllalo sul dispositivo che dava problemi. Se la prova funziona ma il file originale no, il problema potrebbe essere già nel testo originale o nella sua struttura, anziché nel lettore.
Non usare questo test per dichiarare compatibile qualsiasi lingua. Dimostra soltanto che quel piccolo campione viene visualizzato correttamente con quelle impostazioni. Aggiungi i caratteri realmente presenti nel tuo progetto prima di considerare conclusa la verifica.
Portare il testo pulito in Filmora
Importa l'SRT corretto soltanto dopo averne verificato la lettura. Nel progetto Filmora controlla accenti, ritorni a capo e dimensione del testo sull'immagine. Un titolo molto stretto può andare a capo diversamente senza che ci sia alcun problema di codifica.
Esporta un campione con almeno una riga accentata. Se le scritte sono impresse nel video, la loro visualizzazione dipenderà dal rendering già effettuato; se consegni sottotitoli separati, il lettore applicherà le proprie regole. Conserva quindi sia il file testuale sia il progetto e non valutare le due modalità come se fossero equivalenti.
 Download protetto, nessun malware, nessun rischio - solo 1 clic per provare

Modulo risorsa 2 — Testo nel progetto: la guida Filmora a testo e titoli offre un riferimento per la parte grafica. Usa le impostazioni del testo solo dopo aver risolto il contenuto errato nel file.
FAQ: accenti e caratteri strani nei sottotitoli
Cambiare l'estensione da TXT a SRT corregge gli accenti?
No. L'estensione non converte i byte e non ricostruisce i caratteri. Può aiutare un programma a riconoscere il tipo di file, ma servono comunque una codifica corretta e una struttura SRT valida.
Devo scegliere sempre Windows-1252 per l'italiano?
No. Molti file italiani sono già UTF-8. Windows-1252 è una possibilità per materiale legacy occidentale, da confermare osservando il testo originale. La lingua non identifica automaticamente la codifica del file.
Perché vedo è invece di è?
È un indizio tipico di byte interpretati con una codifica diversa da quella usata per salvarli. Torna alla copia originale, prova la corretta lettura e salva soltanto dopo aver verificato più parole, non una sola.
Il simbolo � si può recuperare automaticamente?
Non sempre. Se è stato scritto nel file al posto dei byte originali, l'informazione può essere già persa. Cerca una copia precedente oppure correggi ascoltando il contenuto. Evita di promettere un recupero universale.
Un font diverso risolve ogni carattere strano?
Risolve alcuni problemi di glifi mancanti quando il testo è già corretto. Non ricostruisce una lettera trasformata in una sequenza di caratteri sbagliati. Confronta prima il contenuto in un editor di testo.
Il BOM cambia la pronuncia o la lingua?
No. È un'indicazione iniziale della codifica, non un attributo linguistico. Può influire sulla compatibilità di alcuni software, perciò segui i requisiti della destinazione e verifica un campione prima della consegna.
Posso eliminare tutti gli accenti?
È una soluzione sconsigliata per un testo italiano corretto. Cambia significato o ortografia di alcune parole e maschera la causa tecnica. Conviene sistemare la lettura del file o scegliere un font adeguato.
Perché gli accenti funzionano sul PC ma non sul televisore?
Il televisore può interpretare diversamente la codifica o usare un font limitato. Prova un breve SRT UTF-8, controlla le impostazioni disponibili e consulta i formati supportati dal dispositivo, senza assumere che replichi il lettore del PC.
Posso aprire l'SRT con un elaboratore di testi?
Per questo lavoro è preferibile un editor di testo semplice o di sottotitoli. Un elaboratore può introdurre formattazione e cambiare il tipo di documento. Verifica sempre che il risultato rimanga testo semplice con i timecode intatti.
Qual è il controllo finale più utile?
Riapri il file salvato dal disco, controlla parole accentate in punti diversi e riproducilo sulla destinazione reale. Se esporti un video con scritte impresse, verifica anche il campione renderizzato e non soltanto l'anteprima del progetto.
Per approfondire: Gestire testo e titoli in Filmora.

